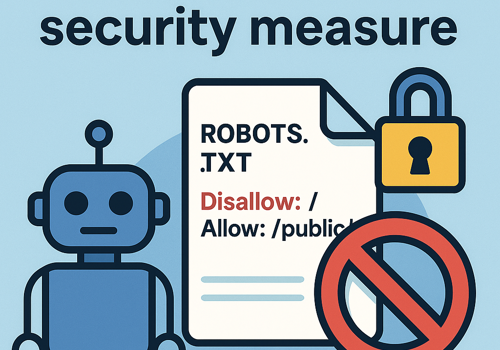
검색 규약의 한계와 서버단 제어의 필요성 많은 운영자들이 robots.txt 파일을 이용해 검색 차단을 시도합니다. 하지만 이 파일은 **보안 도구가 아닌, 검색 엔진에게 보내는 ‘권장 신호’**에 불과합니다. 즉, 규범이지 강제가 아닙니다. 검색엔진이 이 규칙을 지켜줄 수도 있지만, 그건 어디까지나 신사협정 수준의 자율적 준수 체계일 뿐, 법적·기술적으로 ‘보장되는 차단’은 아닙니다. ⚙️ Disallow의 실제 동작 Disallow로 지정된 URL이라도 외부 사이트에서 링크가 걸리면 색인 대상이 될 수 있습니다. 이 경우 검색 결과에는 URL만 노출되고, 사용자가 클릭하면 페이지가 실제로 열립니다. 결국 robots.txt는 색인 차단이 아니라 “크롤링 요청을 자제해달라”는 표지판 정도의 의미에 그칩니다. 🤖 공식 봇도 예외를 둔다 구글, 빙, 스파이더, 네이버 등 양심적인 크롤러들은 대체로 이 규범을 지키지만, 그마저도 완전한 보장은 없습니다. 특정 상황에서는 “이유를 제시하며” 규칙을 무시하고 색인하기도 합니다. (예: 보안 분석, 링크 신뢰도 측정, 캐시 정책 등) 즉, 우리가 이해할 수 없는 내부 정책으로 인해 Disallow된 페이지가 검색에 뜨는 일은 현실적으로 존재합니다. 🕷️ 비공식 봇은 아예 무시한다 진짜 문제는 비공식 크롤러·스크래핑·해킹 봇입니다. 이들은 robots.txt를 무시할 뿐 아니라, 오히려 해당 파일을 ‘탐색 지도’로 활용합니다. “어디를 막았는가?” → “거기에 중요한 정보가 있겠군.” 이런 식으로 공격자가 접근 대상을 추려내는 경우도 적지 않습니다. 따라서 허락되지 않은 봇이 robots.txt 자체를 읽지 못하게 하는 것이 더 중요합니다. 필자의 경우, 정·역방향 DNS 검증을 통과한 소수의 합법 봇(예: Googlebot, Naverbot)만 robots.txt와 sitemap 접근을 허용하고 있습니다. 그 외 모든 비인증 봇은 서버단에서 접근이 즉시 차단됩니다. 🧩 결론: “좋은 봇에게만 통하는 안내문” Disallow: /bbs/와 같은 규칙은 결국 좋은 봇에게만 통하는 금지 안내문일 뿐, 실질적인 차단 장치는 아닙니다. robots.txt만으로는 절대 보안 제어를 할 수 없습니다. 보장되는 차단을 원한다면, HTTP 계층에서의 물리적 접근 제어를 반드시 병행해야 합니다. 예를 들어 Nginx 기준으로는 다음과 같이 설정할 수 있습니다: location ~ ^/bbs/(?!login\.php$) { deny all; } 이렇게 해야만 검색엔진이든 비공식 봇이든 실제로 접근할 수 없는 완전 차단이 구현됩니다. 🔐 마무리 웹서버 운영에 있어서 “색인 제재”보다 더 우선해야 할 과제는, 무수한 스크래핑·해킹 봇을 원천 차단하는 것입니다. robots.txt는 예의범절의 표지판일 뿐, 진짜 보안의 문은 서버단 설정이 지키고 있다는 사실을 운영자는 반드시 인식해야 합니다.